LLMOps คืออะไร?
LLMOps คือแนวทางในการออกแบบ Architecture และ Deploy LLM ให้พร้อมใช้งานพัฒนา AI ครอบคลุม Model Serving, RAG, Monitoring, Security
เผยแพร่เมื่อ
- Artificial Intelligence
- cloud computing
- GPU
- kubernetes
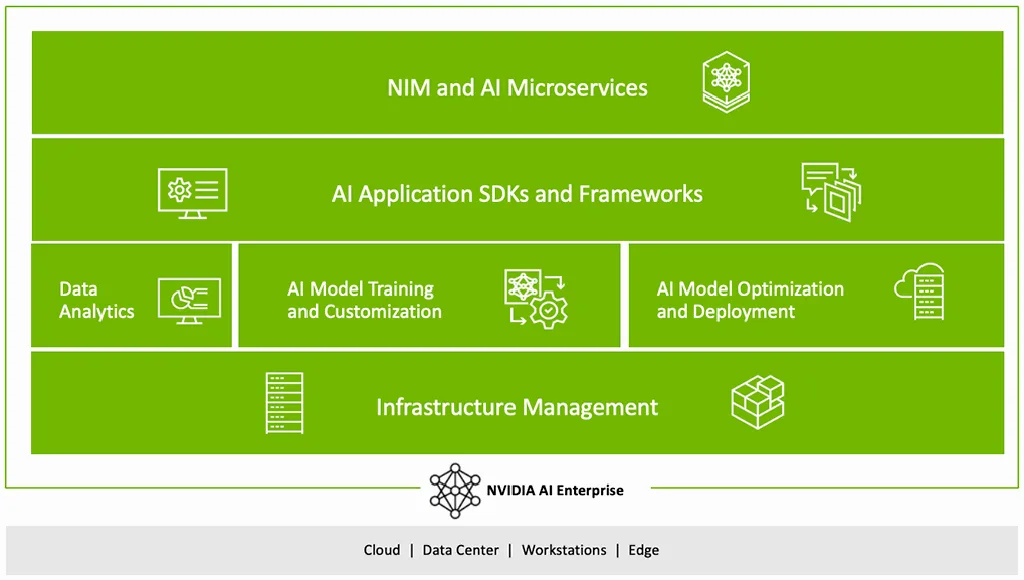
หลายองค์กรวันนี้เริ่มเอา LLM (Large Language Model) ลงใช้งานจริงแล้ว ทั้ง chatbot ตอบคำถามจากเอกสารภายใน และ assistant ช่วยงานประจำวัน แต่การที่ model รันได้ในเดโม กับการที่มันให้บริการทุกวันโดยมีคนใช้พร้อมกันหลายสิบคน เป็นคนละเรื่องกัน ตรงนี้เองที่ LLMOps เข้ามามีบทบาท
LLMOps คืออะไร
LLMOps ย่อมาจาก Large Language Model Operations คือแนวปฏิบัติในการดูแล LLM ตลอดวงจรการใช้งานจริง ต่อยอดจากแนวคิดของ DevOps, MLOps และ Platform Engineering โดยโฟกัสที่ความต้องการเฉพาะตัวของ LLM ครอบคลุมตั้งแต่เตรียม infrastructure, deploy model serving, เชื่อมข้อมูลผ่าน RAG, ติดตามประสิทธิภาพ, ควบคุมเวอร์ชัน ไปจนถึงความปลอดภัยและต้นทุน
พูดง่ายๆ คือ ถ้า LLM คือเครื่องยนต์ LLMOps คือระบบทั้งหมดที่ทำให้เครื่องยนต์นั้นใช้งานจริงได้ทุกวัน อย่างเสถียร วัดผลได้ และควบคุมต้นทุนได้
ทำไมองค์กรที่ใช้ AI จริงจังต้องมี LLMOps
องค์กรที่เอา LLM มาใช้โดยไม่มีแนวปฏิบัติที่ดี มักเจอปัญหาชุดเดียวกัน:
- ระบบตอบช้าหรือไม่เสถียรเมื่อผู้ใช้เยอะ — เดโมลื่นดี พอของจริงมี concurrency สูงก็แตก
- ต้นทุน GPU หรือค่า API สูงเกินจำเป็น — จ่ายเยอะแต่ไม่รู้เงินหายไปตรงไหน
- ข้อมูลภายในถูกใช้โดยไม่มีการควบคุม — ข้อมูลสำคัญไหลออกไปโดยไม่มี guardrail
- ไม่มี monitoring — เกิดปัญหาแล้วไล่หาสาเหตุไม่ได้ ต้องแก้แบบเดาสุ่ม
- deploy model ใหม่ยาก — อัปเดตทีครั้งใช้เวลานาน และเสี่ยงทำสิ่งที่ใช้อยู่พัง
- คำตอบไม่แม่นยำ — เชื่อมข้อมูลภายในเข้ากับ model แบบไม่มีการจัดคุณภาพ ผลลัพธ์คือคำตอบเพี้ยนหรือมโนขึ้นมาเอง
ทั้งหมดนี้มีต้นเหตุร่วมกันคือ ขาดระบบจัดการรอบตัว model วาง LLMOps ไว้ดีตั้งแต่ต้น ทุกปัญหาข้างบนถูกจัดการเป็นระบบตั้งแต่ขั้นออกแบบ
LLMOps ครอบคลุมอะไรบ้าง
1. Infrastructure
รากฐานสำหรับรัน model ให้ใช้งานจริงได้จริง ได้แก่ GPU server, Kubernetes platform, networking และ storage ที่รองรับการ scale ตาม workload องค์กรที่ต้องการควบคุมข้อมูลเองมักเลือกรัน model บน infrastructure ของตัวเอง ซึ่งต้องออกแบบตั้งแต่ hardware จนถึง platform layer
2. Model deployment และ serving
เปิดให้ application เรียกใช้ model ผ่าน API ได้จริง จัดการ concurrency, autoscaling และการรันหลาย model พร้อมกัน เครื่องมือที่นิยมใช้เช่น vLLM, KServe และ Ray Serve เป้าหมายคือผู้ใช้ได้คำตอบเร็วและเสถียร ไม่ว่าจะมีคนใช้พร้อมกันกี่คน
3. RAG และ data integration
เชื่อม LLM เข้ากับข้อมูลภายในองค์กร เช่น เอกสาร คู่มือ หรือฐานความรู้ ผลลัพธ์คือ model ตอบคำถามจากข้อมูลจริงขององค์กรได้ แม่นยำขึ้น และตรงบริบทธุรกิจมากขึ้น
4. Monitoring และ observability
วัดผลการทำงานจริงทั้งฝั่งระบบและฝั่งคุณภาพ เช่น latency, throughput, token usage, error rate, GPU utilization รวมถึงคุณภาพของคำตอบ เมื่อมีตัวเลขจริงในมือ แก้ปัญหาได้เร็วและปรับปรุงได้ตรงจุด
5. Security และ governance
ควบคุมสิทธิการเข้าถึง (access control) เก็บ audit log แยกข้อมูลระหว่างหน่วยงาน (data isolation) และจัดการ secret อย่างเป็นระบบ ยิ่งองค์กรเอาข้อมูลภายในไปให้ model ใช้ตอบคำถามมากเท่าไร ส่วนนี้ยิ่งสำคัญเท่านั้น
6. Cost optimization
ควบคุมค่าใช้จ่ายให้คุ้ม เช่น เลือก serving architecture ให้เหมาะกับ workload, จัดสรร GPU อย่างมีประสิทธิภาพ, ใช้ caching ลดงานซ้ำ และจัดวาง workload ให้เหมาะกับขนาดของ model
ตัวอย่างการใช้งานจริง
AI Chatbot สำหรับพนักงานภายในองค์กร พนักงานถามเรื่อง HR, IT support หรือ policy ของบริษัท แล้วได้คำตอบจากเอกสารภายในทันที ทีม IT และ HR ลดภาระงานตอบคำถามซ้ำๆ ลงได้มาก
Private LLM สำหรับข้อมูลสำคัญ องค์กรด้านการเงินหรือสุขภาพที่มีข้อจำกัดเรื่องข้อมูล รัน LLM บน infrastructure ของตัวเองได้ ข้อมูลไม่ออกนอกองค์กร ใช้ AI ได้อย่างมั่นใจเรื่องความปลอดภัย
RAG สำหรับค้นคว้าความรู้จากเอกสารจำนวนมาก องค์กรที่มีเอกสารนับพันหน้า ต่อยอดเป็นระบบค้นหาที่ตอบคำถามได้ตรงจุด พร้อมเอกสารอ้างอิงต้นทาง ผู้ใช้ถามเป็นภาษาธรรมชาติแล้วได้คำตอบที่น่าเชื่อถือ ค้นคว้าได้เร็วขึ้นชัดเจน
Model Serving เป็น backend ของ AI assistant Model serving ทำหน้าที่เป็น backend ให้ AI assistant หรือ customer support bot ทำงานต่อเนื่อง รองรับผู้ใช้จำนวนมากพร้อมกัน ด้วย latency ที่ควบคุมได้
องค์กรแบบไหนที่ควรเริ่มทำ LLMOps
LLMOps เหมาะกับองค์กรที่มีเป้าหมายใช้งาน AI อย่างจริงจัง โดยเฉพาะกรณีเหล่านี้:
- มีการทดสอบ LLM แล้วและต้องการยกระดับขึ้นสู่ production
- ต้องการเชื่อม AI เข้ากับข้อมูลภายในองค์กร
- ต้องการควบคุมข้อมูล ความปลอดภัย และต้นทุนด้วยตัวเอง
- ต้องการ deploy โมเดลบน cloud, on-premise หรือ hybrid environment
- มี use case ที่เกี่ยวข้องกับ chatbot, copilots, knowledge search หรือ document intelligence
LLMOps ต่างจาก MLOps อย่างไร
MLOps ดูแลวงจรชีวิตของ machine learning ทั่วไป ทั้ง data pipeline, experiment tracking, training pipeline และ model registry เหมาะกับ predictive models เช่น การพยากรณ์ยอดขายหรือจัดหมวดหมู่เอกสาร
LLMOps โฟกัสเฉพาะ LLM ที่มีความท้าทายเฉพาะตัว เช่น prompt flow, การจัดการ token usage, context handling, RAG pipeline, vector database และ governance ของ generative AI
พูดสั้นๆ คือ MLOps ครอบคลุมกว้าง LLMOps เจาะลึกเฉพาะงาน LLM องค์กรที่ใช้ LLM เป็นหลักจะได้แนวปฏิบัติที่ออกแบบมาเพื่องานนี้โดยตรง
หากองค์กรต้องการเริ่มต้น LLMOps ควรเริ่มจากอะไร
- ประเมิน use case ที่ต้องการใช้งานจริงก่อน
- เลือก architecture ที่เหมาะกับขนาดงานและข้อกำหนดด้านข้อมูล
- วางแผนเรื่อง model serving, data integration และ RAG ตั้งแต่ต้น
- เตรียม monitoring, security และ cost control ให้พร้อมก่อนขึ้น production
- ออกแบบ platform ให้รองรับการขยายในอนาคต
อ่านพื้นฐานที่เกี่ยวข้อง: AI Factory คืออะไร และ Kubernetes คืออะไร
สรุป
LLMOps คือชุดแนวปฏิบัติที่เปลี่ยน LLM จากของเล่นในเดโม ให้เป็นระบบที่ใช้งานจริงได้ทุกวัน ครอบคลุมตั้งแต่ infrastructure, model serving, RAG, monitoring, security ไปจนถึงการควบคุมต้นทุน องค์กรที่วางรากฐานส่วนนี้ไว้ดี จะพัฒนาฟีเจอร์ AI ใหม่ได้เร็วขึ้น ระบบเสถียรขึ้น และควบคุมงบประมาณได้จริง
Zotect ให้บริการ LLMOps ครบทั้ง model serving, deployment workflow, การต่อยอดด้วย RAG, observability และ security — ดูรายละเอียดที่หน้า LLMOps หรือ ติดต่อทีมงาน