AI Factory คืออะไร
สรุปครบทุกประเด็นด้าน AI Factory ตั้งแต่ GPU Orchestration ไปจนถึงการออกแบบ Data Center ยุคใหม่เพื่อการผลิต AI ในระดับอุตสาหกรรม
เผยแพร่เมื่อ
- Artificial Intelligence
- GPU
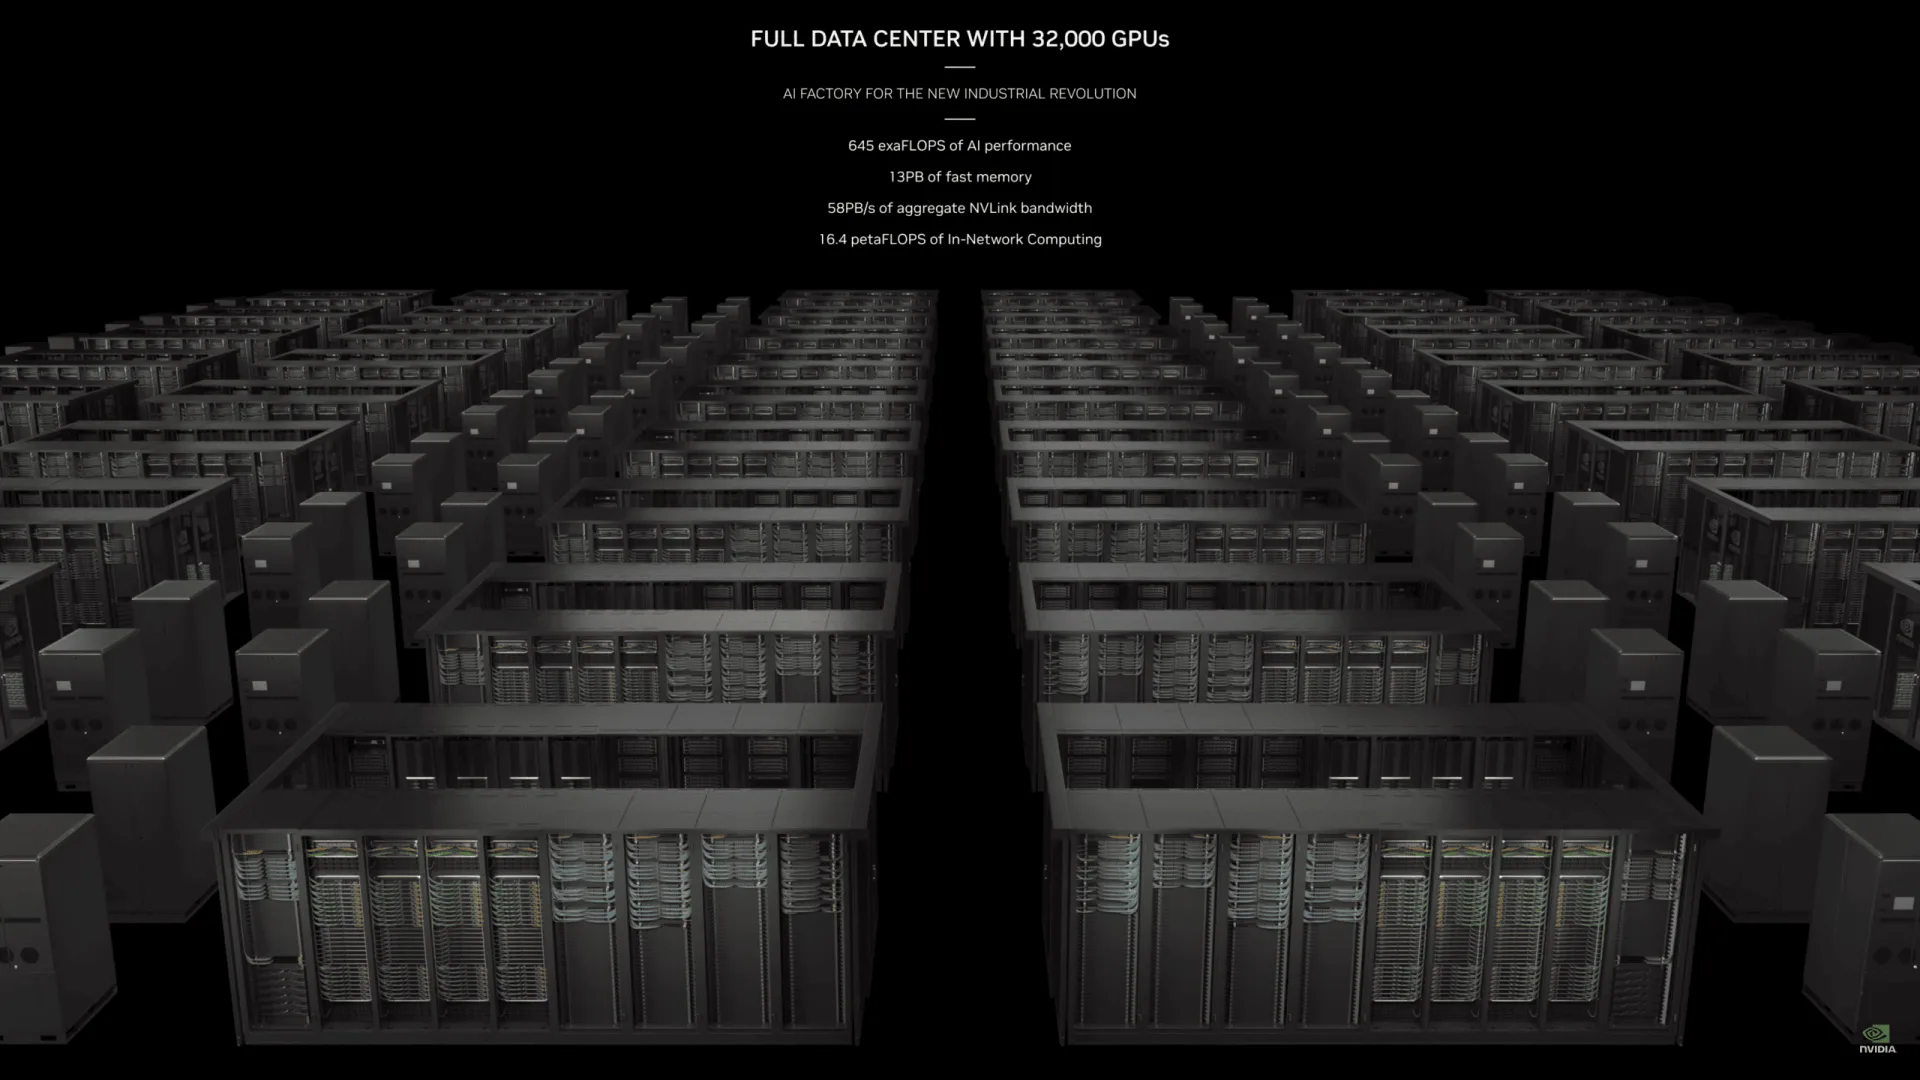
AI Factory คือโครงสร้างพื้นฐานไอทีที่ออกแบบมาเพื่อผลิตงาน AI ต่อเนื่องระดับอุตสาหกรรม ถ้าโรงงานทั่วไปรับวัตถุดิบเข้าแล้วส่งสินค้าออก AI Factory ก็รับข้อมูลดิบเข้า ประมวลผลผ่าน GPU ประสิทธิภาพสูง แล้วส่งโมเดล AI ที่พร้อมใช้ออกมา แล้ววนกลับไปเทรนรุ่นใหม่ต่อเนื่อง
ความต่างจาก data center ทั่วไปอยู่ที่จุดประสงค์ Data center ทั่วไปออกแบบให้เว็บไซต์ ฐานข้อมูล และระบบสำนักงานทำงานเสถียร โหลดแต่ละตัวไม่หนักมาก AI Factory ออกแบบให้ GPU หลายพันตัวทำงานเต็มที่พร้อมกันตลอดเวลา ซึ่งดันทั้ง network, storage และ cooling ให้ไปไกลกว่าที่ระบบทั่วไปรับได้ ถ้าเอา GPU cluster ไปวางบน infrastructure แบบเดิม สิ่งที่เกิดขึ้นคือ GPU นั่งรอข้อมูล ค่าไฟวิ่งเต็ม แต่งานไม่คืนเต็มที่
องค์ประกอบหลัก 3 ส่วน
High-performance networking
การเทรนโมเดลขนาดใหญ่แบ่งงานให้ GPU หลายตัวช่วยกัน GPU ต้องสื่อสารกันตลอดเวลา ถ้า network ช้า ทุกตัวต้องรอ งานทั้งก้อนช้าลงตาม
เทคโนโลยีหลักคือ InfiniBand หรือ Ethernet ที่รองรับ RoCE v2 ให้ latency ต่ำมาก และรองรับ GPUDirect RDMA ที่ให้ GPU ส่งข้อมูลหากันตรงๆ โดยไม่ผ่าน CPU ลดขั้นตอนและ overhead ระหว่างทาง topology แบบ non-blocking Fat-Tree ทำให้ GPU ทุกคู่ส่งข้อมูลกันได้เต็ม bandwidth พร้อมกันทั้ง cluster ไม่มีทางแคบที่กลางระบบ
High-performance storage
GPU เทรนเร็วแค่ไหนขึ้นกับว่าข้อมูลไหลมาเร็วแค่ไหน ข้อมูลชุดใหญ่หลายเทราไบต์ต้องส่งถึง GPU ทุกโหนดพร้อมกันทุก epoch Parallel file system อย่าง CephFS หรือ Lustre แยกไฟล์ออกเป็นชิ้นเล็กๆ แล้วอ่านพร้อมกันจากหลายเซิร์ฟเวอร์ ทำให้ throughput รวมระดับหลายร้อย GB/s เป้าหมายเดียวคือ GPU ไม่ idle รอดิสก์
Data center design: power และ cooling
ตู้เซิร์ฟเวอร์สำหรับ GPU กินไฟระดับ 40–100 kW ขึ้นไปต่อตู้ หลายเท่าของตู้ทั่วไป ระบบลมเย็นแบบเดิมระบายความร้อนไม่ทัน ต้องใช้ liquid cooling หรือ Rear Door Heat Exchanger ช่วยดึงความร้อนออกใกล้ตัวเครื่อง พร้อมกับวางแผนกำลังจ่ายไฟและพื้นที่รับน้ำหนักให้รองรับตั้งแต่ต้น
ฟีเจอร์ที่ทำให้ใช้งานจริงได้
GPU orchestration — Kubernetes จัดคิวงาน จัดสรร GPU ให้หลายทีมใช้ร่วมกัน รวมถึงแบ่ง GPU ตัวเดียวเป็นหลาย instance สำหรับงานเล็ก ทรัพยากรไม่นั่งว่าง
Automated pipeline — ระบบ MLOps รันขั้นตอน train, test, deploy ต่อเนื่องอัตโนมัติ โมเดลรุ่นใหม่ออกสู่ระบบจริงได้เร็วขึ้น
Scalability — เริ่มจาก GPU ไม่กี่ตัว แล้วขยายเพิ่มได้เรื่อยๆ จนถึงระดับ supercomputer โดยไม่ต้องออกแบบใหม่ทั้งระบบ
Resiliency — เทรนโมเดลใหญ่ใช้เวลาหลายวันถึงหลายสัปดาห์ ระบบ checkpoint บันทึกสถานะเป็นระยะ เมื่อเกิด fault งานกลับมาจากจุดล่าสุดได้ทันที
ประโยชน์ต่อองค์กร
Data sovereignty — ข้อมูลอยู่ในระบบที่องค์กรควบคุมเอง เหมาะกับเอกสารภายใน ข้อมูลลูกค้า หรือข้อมูลที่กฎหมายกำหนดว่าต้องเก็บไว้ในประเทศ พร้อมลด latency เพราะข้อมูลอยู่ใกล้ผู้ใช้
ควบคุม compliance ได้ดีขึ้น — นโยบายความปลอดภัย การเข้าถึง และการเก็บ log อยู่ในมือองค์กรทั้งหมด ตรวจสอบและปรับได้ตามข้อกำหนดของอุตสาหกรรมตัวเอง
ลด TCO ระยะยาว — สำหรับงานที่รันต่อเนื่อง 24 ชั่วโมง การลงทุน infrastructure ของตัวเองในระยะยาวมักคุ้มค่ากว่าเช่า public cloud ที่คิดเงินตามการใช้งานตลอดเวลา องค์กรที่มี workload ต่อเนื่องจริงควรคำนวณจุดคุ้มทุนด้วยตัวเลข workload ของตัวเอง
สร้างความสามารถด้าน AI ของตัวเอง — ทีมในองค์กรพัฒนาโมเดลจากข้อมูลของตัวเองได้ต่อเนื่อง ตัวอย่างที่เห็นชัด: LLM องค์กรที่เทรนจากเอกสารภายในซึ่งส่งออกไปไหนไม่ได้ และ computer vision ที่ต้องอ่าน-เขียนไฟล์วิดีโอจำนวนมากพร้อมกัน
สรุป
AI Factory คือการออกแบบ infrastructure ทั้งระบบเพื่องาน AI โดยเฉพาะ — network ให้ GPU คุยกันเร็ว storage ให้ข้อมูลไหลทัน ตู้และ cooling รับไฟหนักได้ แล้ว orchestration ประสานทุกอย่างให้ทำงานต่อเนื่องอัตโนมัติ
ทีม Zotect ทำงานด้าน AI Infrastructure ตั้งแต่วางแผน facility ระบบ networking และ storage จนถึงติดตั้ง GPU cluster และจัดการ workload ด้วย Kubernetes — ดูรายละเอียดที่หน้า AI Infrastructure หรือ ติดต่อทีมงาน